
یادگیری تقویتی و هوش مصنوعی
خلاصه:هسته اصلی هوش مصنوعی مدرن، به ویژه رباتیک، و وظایف متوالی، یادگیری تقویتی است. اگرچه RL سالهاست که وجود داشته است، آن را به سومین پایه از چهارپایه یادگیری ماشین تبدیل کرده است و برای دانشمند داده که بداند چه زمانی و چگونه باید آن را اجرا کند، اهمیت فزایندهای دارد.
اگر چند سال پیش با گروهی از دانشمندان داده در مورد تعداد انواع مشکلات یادگیری ماشینی نظرسنجی میکردید، تقریباً به طور قطع یک پاسخ دودویی دریافت میکردید: انواع مسئله به وضوح به دو دسته تحت نظارت و بدون نظارت تقسیم میشوند.
- تحت نظارت: دادههای برچسبگذاری شده (نمونههایی به وضوح تعریف شده) دارید.
- بدون نظارت: شما داده ای دارید اما برچسب گذاری نشده است. ببینید آیا ساختاری در آن وجود دارد یا خیر.
امروزه اگر همین سوال را بپرسید، به احتمال زیاد متوجه خواهید شد که انواع مشکلات یادگیری ماشین به سه دسته تقسیم می شوند:
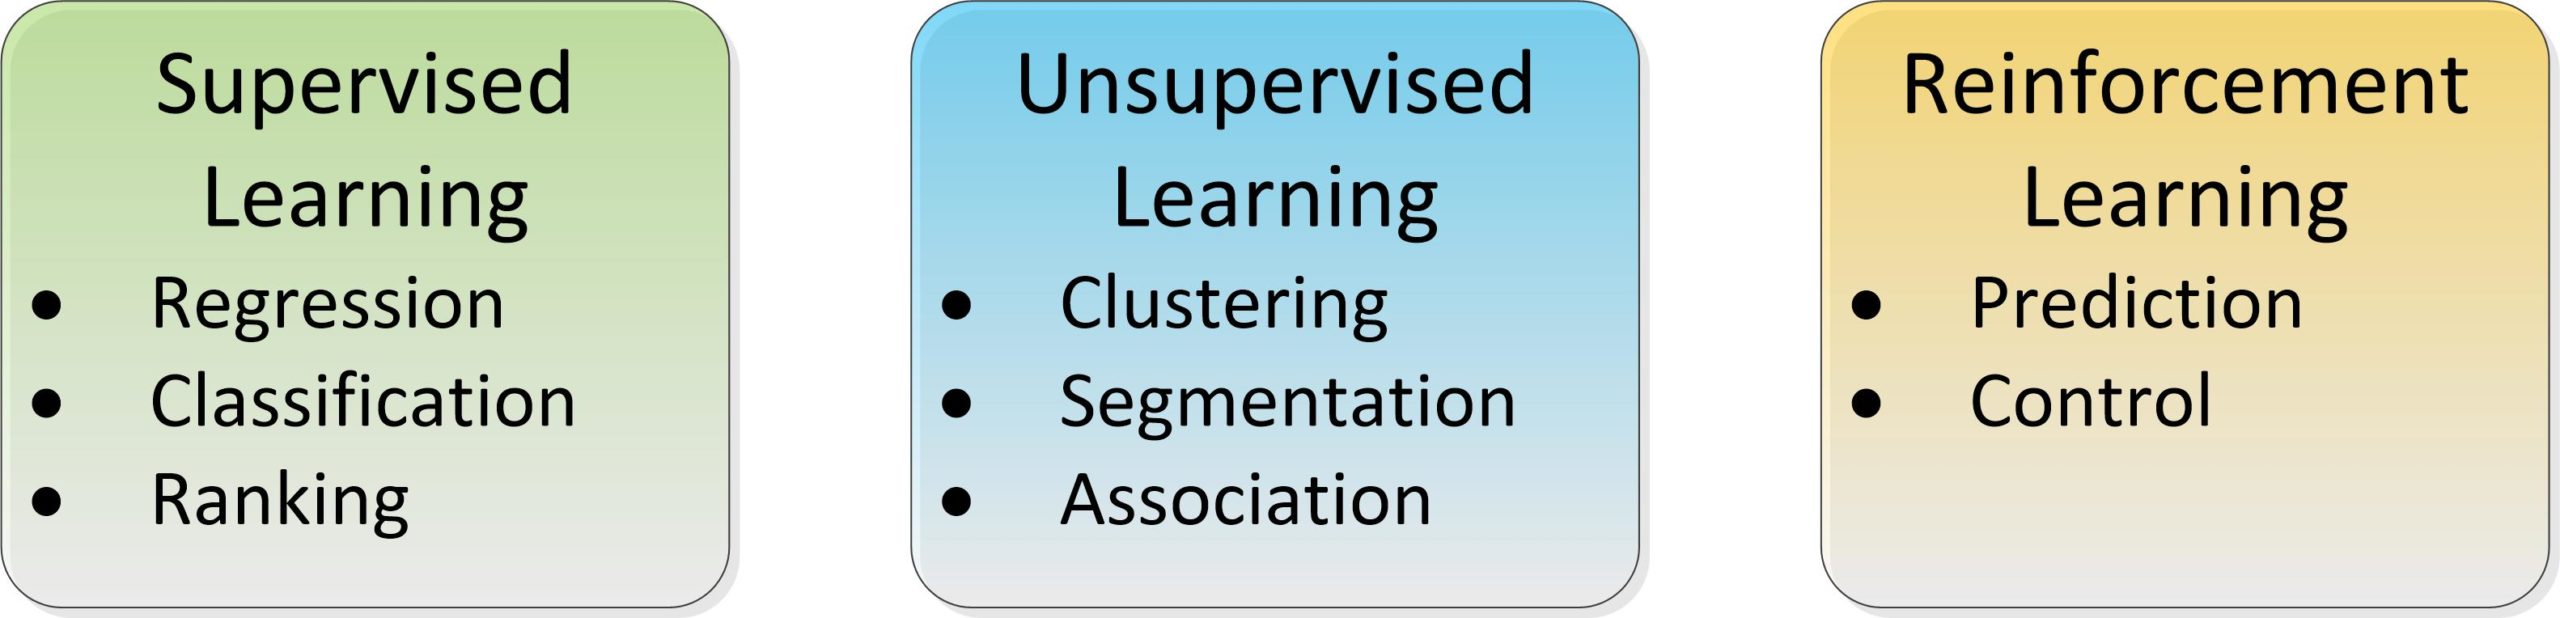
در حالی که یادگیری تقویتی (RL) حداقل از دهه 80 و قبل از آن در علوم رفتاری وجود داشته است، معرفی آن به عنوان یک بازیگر اصلی در یادگیری ماشین نشان دهنده اهمیت روزافزون آن در هوش مصنوعی است.
کلید درک زمان استفاده از یادگیری تقویتی این است:
- داده هایی برای یادگیری در حال حاضر وجود ندارد
- یا نمی خواهید برای جمع آوری آن صبر کنید (زیرا تاخیر ممکن است پرهزینه باشد)
- یا ممکن است داده ها به سرعت تغییر کنند و باعث شود که نتیجه سریعتر از یک چرخه به روز رسانی مدل معمولی تغییر کند.
چه مشکلاتی متناسب با این توصیف است؟ کنترل رباتیک برای یکی و بازی برای دیگری، که هر دو تمرکز اصلی هوش مصنوعی در چند سال گذشته بوده است.
برای سادهسازی بسیار، روشهای RL برای رسیدگی به دو نوع مشکل به کار گرفته شدهاند:
- پیش بینی:برای هر ترکیبی از وضعیتهای احتمالی آینده چقدر میتوان انتظار پاداش داشت. (مثلاً بر اساس مجموعه مراحل زیر چقدر می توانیم امیدوار باشیم که از حساب های معوق جمع آوری کنیم؟)
- کنترل:با حرکت در میان تمام ترکیبات ممکن محیط (تعامل با محیط یا فضای حالت)، ترکیبی از اقدامات (یک «سیاست» در RL-speak) را پیدا کنید که پاداش را به حداکثر میرساند و امکان برنامهریزی اقدام و کنترل بهینه را فراهم میکند. (به عنوان مثال چگونه یک وسیله نقلیه خودران را هدایت کنیم، یا چگونه در یک بازی شطرنج برنده شویم.)
ما چند مثال اضافی برای روشن شدن این موضوع ارائه خواهیم کرد، اما شما باید بلافاصله سردرگمی ایجاد شده با معرفی این نوع سوم ML را درک کنید. تمایز بین انواع مشکل تحت نظارت و بدون نظارت هم با تعریف مشکل و هم با داده های موجود بلافاصله مشخص شد.
از سوی دیگر، RL با نبود دادههای از قبل موجود تعریف میشود، اما اهدافی دارد که اگر ابتدا دادههای آموزشی را جمعآوری کردید، میتوان با تکنیکهای نظارت شده یا بدون نظارت نیز به آن پرداخت. به عنوان مثال، پیشبینی ارزش به وضوح در حوزه مسائل نظارت شده نیز قرار دارد، و برخی از مشکلات کنترل که بر نتایج بهینهشده تمرکز دارند نیز میتوانند با تکنیکهای نظارت شده یا حتی بدون نظارت پاسخ داده شوند.
ریشه های یادگیری تقویتی
مفاهیم زیربنایی RL از مطالعات رفتار حیوانات می آید. یکی از رایج ترین نمونه هایی که استفاده می شود نمونه غزال نوزاد تازه متولد شده است. اگرچه بدون هیچ درک یا مدلی از نحوه استفاده از پاهای خود متولد می شود، اما در عرض چند دقیقه ایستاده و در عرض 20 دقیقه می دود. این یادگیری از تعامل سریع با محیط آن، یادگیری پاسخهای عضلانی موفقیتآمیز و دریافت پاداش با بقا ناشی میشود.
مفاهیم اولیه RL
RL دقیقاً همین است: سیستمی که در آن موفقیت از طریق تعامل با محیط خود از طریق آزمون و خطا آموخته می شود. برخلاف یادگیری نظارت شده و بدون نظارت که هر دو دارای داده هایی برای یادگیری هستند، RL داده های خود را از طریق تجربه و تعیین “مدل قهرمان” از طریق آزمون و خطا، و تقویت خالص می سازد. عوامل RL از تجربیات خود یاد می گیرند، برخلاف یادگیرندگان تحت نظارت که نمونه هایی برای یادگیری دارند
ایده اصلی پشت RL خود سادگی است.
- “محیط” به عنوان ماتریس تمام مقادیر یا مراحل جایگزین ممکن است که می توان برداشت کرد. (حرکات احتمالی همه مهرهها در بازی چکرز یا تمام اصلاحات احتمالی فرمان را در نظر بگیرید که یک مکانیزم فرمان خودکار میتواند در پاسخ به ورودی حسگر بصری جاده پیش رو انجام دهد).
- “عامل” الگوریتم RL است. فقط یکی نیست، انواع زیادی دارد.
- عامل شروع به کاوش تصادفی اقدامات جایگزین در محیط می کند و در صورت موفقیت آمیز بودن حرکت، عامل را تقویت می کند.
- “وضعیت” مجموعه فعلی حرکات یا مقادیر است که پس از هر بار تلاش اصلاح می شود و به دنبال بهینه سازی پاداش از طریق حلقه بازخورد است.
- عامل باید از تجربیات خود در مورد محیط زیست در حین کاوش در طیف کامل ایالت های ممکن بیاموزد.
- راهحل یا الگوریتم بهدستآمده «سیاست» نامیده میشود. خطمشی مجموعهای از مراحل یا رویههایی است که منجر به بهینهسازی پاداش میشود.
نمونه مشکلات
چند مثال اضافی از مشکلاتی که RL انتخاب خوبی است.
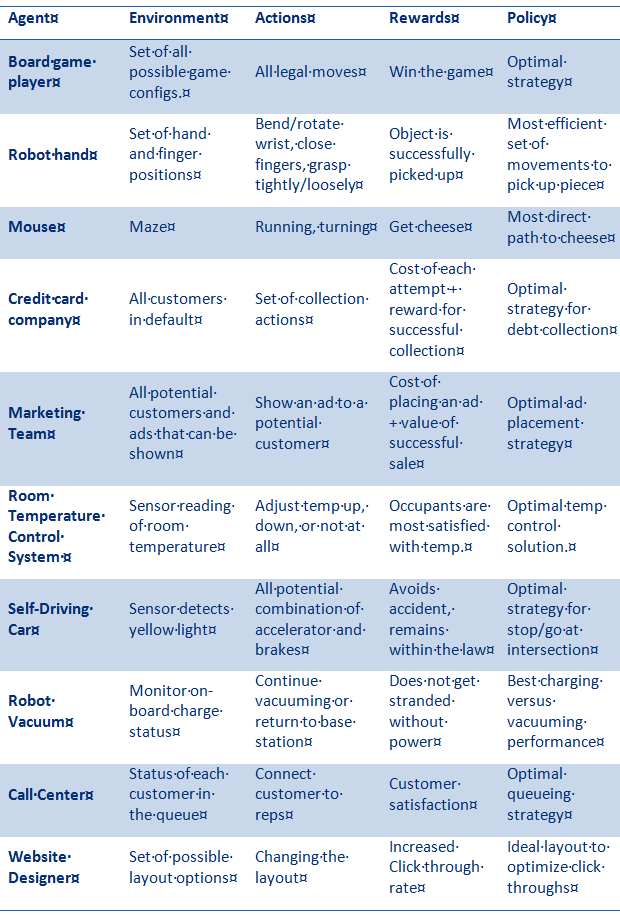
همپوشانی با یادگیری نظارت شده و برخی از استراتژی های RL
در جدول بالا به طور خاص به مثالهای «تیم بازاریابی» و «طراح وبسایت» نگاه کنید و باید مشکلاتی را بشناسید که در آنها تست کلاسیک A/B یا یک مشکل طبقهبندی نظارت شده برای شناسایی بهترین مشتریان بالقوه راهحلهای تاریخی بوده است. هر دوی اینها به آزمایشهای در حال اجرا برای جمعآوری دادههای آموزشی و سپس مدلسازی و اعمال نتایج نیاز دارند. به طور مشابه، اگر دادههای آموزشی در دسترس بود، بسیاری از مشکلات دیگر به مدلسازی تحت نظارت یا بدون نظارت منتهی میشوند.
به عنوان مثال تست A/B را در نظر بگیرید. تمرینکننده RL میگوید: «چرا منتظر دادههای آموزشی باشیم؟ بیایید شروع کنیم به نشان دادن گزینهها (احتمالاً بیشتر از A و B) به مشتریان و نشان دادن آنهایی که بهترین نتایج را دارند ادامه دهیم.»
این در واقع هسته استراتژی RL با این استثنا است. اگر به عامل اجازه دهیم خیلی سریع در مورد آنچه که به نظر می رسد راه حل برنده است، تسویه حساب کند، ممکن است هرگز تمام گزینه های دیگر (گستره کامل فضای دولت) را بررسی نکند. این ممکن است منجر به نصب بیش از حد یا قطع زودهنگام یک Optima محلی شود.
برای به حداقل رساندن این احتمال، در طراحی عامل RL باید از یک تتا حریص (Ɵ) استفاده کنیم. این عامل به عامل می گوید که با چه سرعتی به جستجوی تصادفی در فضای State برای راه حل بهتر ادامه دهد. آن را خیلی بالا تنظیم کنید و ممکن است بهینه سازی سیستم خیلی طول بکشد. آن را خیلی پایین تنظیم کنید، سیستم ممکن است هرگز بخشی از فضای حالت را بررسی نکند. (برای اطلاعات بیشتر در مورد این، راهزنان چند مسلح و فرآیند تصمیم گیری مارکوف را ببینید).
چهار مشکلی که RL باید با آنها مقابله کند
در طراحی پروژه RL شما چهار مشکل وجود دارد که باید با آنها مقابله کنید (کوین مورفی، 1998، فلورنتین وورگوتر و برند پور، 2008).
- تجارت اکتشاف و بهره برداری: آیا باید به کاوش در فضای State ادامه دهیم یا آنچه را که می بینیم کار می کند، پایبند باشیم. این موضوع در مثال A/B Tradeoff در بالا بررسی شده است.
- مشکل تاخیر در پاداش:هنگام انجام یک بازی تخته، ارزش هر حرکت را نمی توان در خلاء در نظر گرفت، بلکه تنها می تواند قوی یا ضعیف در نظر گرفته شود که آیا بازی پس از چندین حرکت برنده شده یا باخته است. کدام حرکت در آن سکانس طولانی در واقع عامل برد یا باخت بود؟ راه حل های این سوال در حوزه یادگیری تفاوت زمانی است.
- محیط های غیر ساکن:ما می خواهیم که عامل با محیط تعامل داشته باشد و از آن بیاموزد. اما اگر محیط خیلی سریع تغییر کند چه اتفاقی می افتد؟ چقدر به گذشته های دور در مقابل گذشته نزدیک وزن می دهیم؟ آیا این تغییر نشان دهنده عدم تداوم با گذشته است؟ اگر دینامیک محیط به آرامی و پیوسته تغییر کند، احتمالاً مشکلی نیست، اما الگوریتمهای RL خیلی سریع همگرا نمیشوند. این می تواند منجر به شکست حتی در یک محیط به آرامی در حال تغییر شود.
- تعمیم:در یک فضای چند بعدی بزرگ، انفجار ترکیبی و سرعت محاسبه به این معنی است که بعید است ما بتوانیم از همه گزینههای ممکن در فضای حالت بازدید کنیم و بنابراین باید به یک زیرمجموعه بسنده کنیم. این منجر به این سوال واضح می شود که آیا زیرمجموعه نماینده است و آیا راه حل تعمیم خواهد یافت. استخراج ویژگی و کاهش ابعاد به استراتژی های مهمی تبدیل می شوند. واقعیت این است که غلبه بر این نفرین ابعاد در RL دشوار است و آن را برای حالتهای با ابعاد کم مناسب میسازد.
همه اینها زمینه های تحقیق و اکتشاف فعال هستند. با افزایش سرعت محاسبات و کاهش هزینهها، میتوانیم از زیر مجموعههای بزرگتر فضای State بازدید کنیم و گزینههای تاخیر زمانی بیشتری را بررسی کنیم. بسیاری از این راهحلها اصولی را از شبکههای عصبی، انتشار به عقب، رویههای تکاملی یا بازپخت مانند، و ساختارهای فاکتوری به کار میگیرند که همگی عمدتاً در حوزههای یادگیری تحت نظارت و بدون نظارت قرار دارند. این تلاقی دامنهها میتواند گیجکننده باشد، اما اینکه کجا و چگونه RL اعمال شود، دانش روزافزون مهمی برای دانشمندان داده است.
