
علم داده پشت هوش مصنوعی
ما و دیگران در مورد انواع مختلف علم داده که هوش مصنوعی را تشکیل می دهند، مطالب زیادی نوشته ایم. هنوز هم میشنوم که بسیاری از مردم در مورد هوش مصنوعی میپرسند که انگار یک موجود واحد است. این نیست. هوش مصنوعی مجموعهای از فناوریهای علم داده است که در این مرحله از توسعه حتی بهخوبی ادغام نشدهاند یا حتی برای استفاده آسان نیستند. با این حال، در هر یک از این زمینهها، ما پیشرفت زیادی کردهایم و این توجه مطبوعات محبوب را به خود جلب کرده است.
هدف این مقاله یک شیرجه عمیق نیست، بلکه نمایش ضرب المثل 50000 فوتی از آنچه در حال وقوع است است. اگر شما یک دانشمند داده سنتی هستید که مقالاتی را خوانده اید اما هنوز تصویر کلی را جمع آوری نکرده اید، ممکن است این روش را راهی برای ادغام دانش فعلی خود و حتی کشف مکان هایی که علاقه مند به تمرکز هستید بیابید.
هوش مصنوعی به سادگی مجموع بخش های علم داده آن است
“قطعات” علم داده که هوش مصنوعی را تشکیل می دهند در دسته های زیر قرار می گیرند. در اینجا همپوشانی وجود دارد، اما اینها موضوعات مفصلی است که در مطبوعات خواهید دید.
- یادگیری عمیق
- پردازش زبان طبیعی
- تشخیص تصویر
- یادگیری تقویتی
- دستگاه های پاسخگویی به سوالات
- آموزش خصمانه
- رباتیک
اینها همه رشته های جداگانه ای هستند (OK، مقوله یادگیری عمیق در واقع شامل برخی از رشته های دیگر است). هوش مصنوعی به سادگی مجموع این بخش هاست. آنها بهصورت بسیار ضعیفی به هم متصل میشوند و توسط تعداد زیادی از استارتآپها و بازیگران اصلی به برنامههای واقعاً شگفتانگیزی متصل شدهاند. هنگامی که آنها به خوبی با هم کار می کنند، به عنوان مثال در Watson، یا Echo/Alexa، یا همانطور که در اتومبیل های خودران شروع به کار می کنند، ممکن است بیشتر از مجموع قطعات خود به نظر برسند. اما آنها نیستند. ادغام این فناوری های مختلف هنوز یکی از بزرگترین چالش هاست.
هوش مصنوعی ما باید چه کاری انجام دهد؟
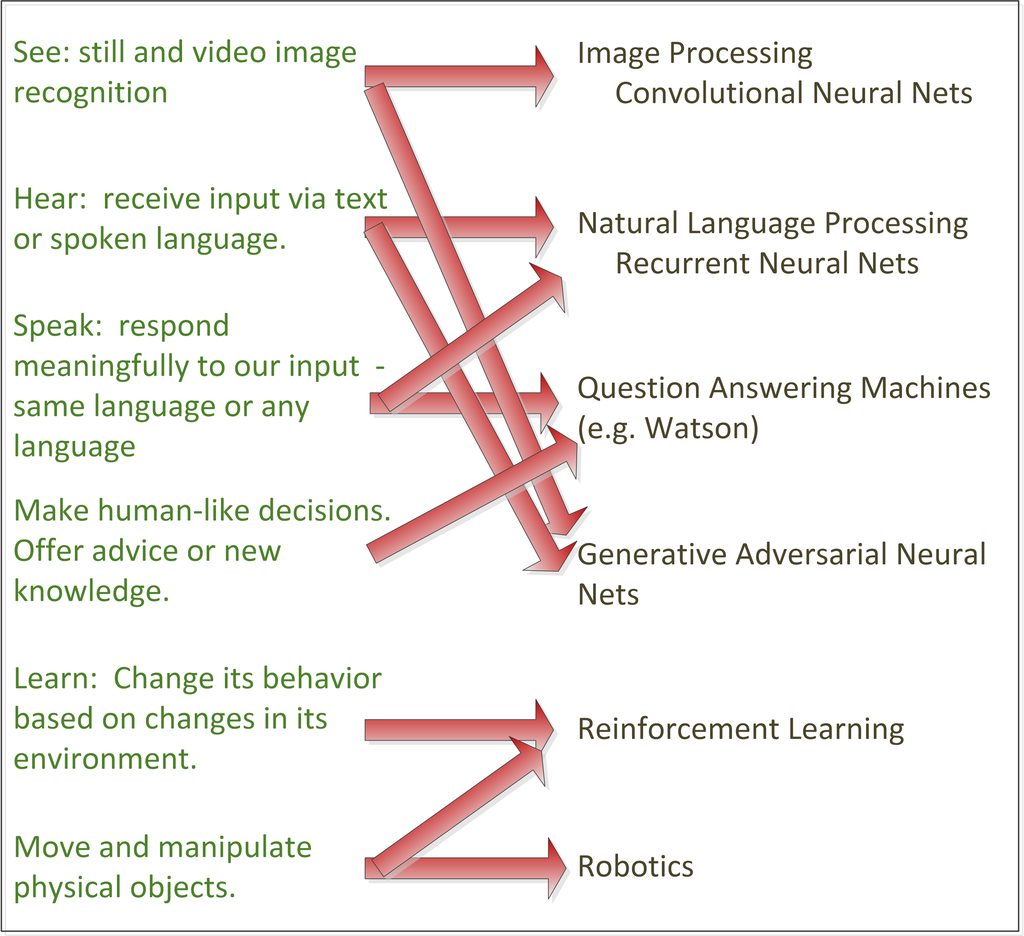
وقتی این را برای مبتدیان توضیح می دهم، همیشه مفید است که با این توصیف انسان نما از توانایی های انسان مانندی که هوش مصنوعی ما باید داشته باشد شروع کنم.
دیدن:این تشخیص تصویر ثابت و ویدیویی است.
شنیدن:دریافت ورودی از طریق متن یا زبان گفتاری
صحبت:به ورودی ما به طور معناداری یا به همان زبان یا حتی یک زبان خارجی پاسخ می دهند.
تصمیمات انسانی بگیرید:مشاوره یا دانش جدید ارائه دهید.
فرا گرفتن:رفتار خود را بر اساس تغییرات در محیط خود تغییر دهد.
حرکت:و اشیاء فیزیکی را دستکاری کنید.
می توانید بلافاصله متوجه شوید که بسیاری از کاربردهای تجاری هوش مصنوعی که امروزه در حال ظهور هستند، تنها به تعداد کمی از این قابلیت ها نیاز دارند. اما برنامه های پیچیده تری که ما منتظر آن هستیم تقریباً باید همه اینها را داشته باشند.
تبدیل قابلیتهای انسانمانند به علم داده
اینجاست که این کمی به هم ریخته می شود. هر یک از این قابلیت ها لزوماً با علم داده زیربنایی خود یک به یک مطابقت ندارند. اما اینکه چگونه علم داده با این الزامات مطابقت دارد، مهمترین بخش درک واقعی آنچه امروز در هوش مصنوعی میگذرد است. به عنوان یک نمودار، آنها کم و بیش مانند این مطابقت دارند:
چه اتفاقی برای یادگیری عمیق افتاد
ممکن است متوجه شده باشید که «یادگیری عمیق» در نمودار ما وجود ندارد. به این دلیل که این یک دسته خلاصه برای شبکه های عصبی برگشتی و شبکه های عصبی کانولوشنال در بالا است. شبکه های عصبی مصنوعی (ANN)، بالاترین سطح خلاصه از دهه 80 وجود داشته است و همیشه بخشی از کیت ابزار استاندارد یادگیری ماشین علم داده برای حل مشکلات طبقه بندی استاندارد و رگرسیون بوده است.
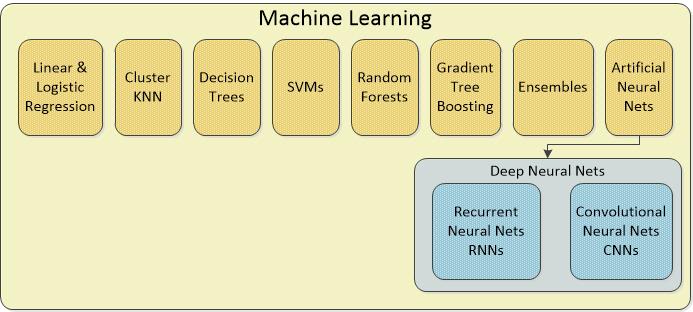
آنچه اخیراً اتفاق افتاده این است که افزایش عظیم ما در پردازش موازی، پردازش ابری و استفاده از GPU (واحدهای پردازش گرافیکی) به جای تراشههای سنتی اینتل به ما این امکان را میدهد تا با نسخههایی از ANN که دهها یا حتی بیش از صد لایه پنهان دارند آزمایش کنیم. . این لایههای پنهان چیزی است که باعث میشود این انواع را «عمیق» بنامیم، از این رو «یادگیری عمیق». افزودن لایههای پنهان به معنای چند برابر شدن پیچیدگی محاسباتی است، به همین دلیل باید منتظر ماند تا سختافزار به جاهطلبیهای ما برسد.
حداقل 27 نوع مختلف ANN وجود دارد، اما مهمترین آنها شبکه های عصبی کانولوشن (CNN) و شبکه های عصبی بازگشتی (RNN) هستند که بدون آنها پردازش تصویر و زبان طبیعی امکان پذیر نخواهد بود.
یک بحث (بسیار) مختصر در مورد علم داده
اجرای عدالت در مورد هر یک از این فناوریهای علم داده اساسی نیازمند مقالات متعدد است. کاری که ما در اینجا سعی خواهیم کرد انجام دهیم این است که مختصری از توضیحات و چند پیوند به اطلاعات کاملتر را در اختیار شما قرار دهیم.
شبکه های عصبی کانولوشنال (CNN):CNN ها در قلب انواع تشخیص تصویر و ویدیو، تشخیص چهره، برچسب گذاری تصویر (فکر کنید فیس بوک) و تشخیص علامت توقف از عابر پیاده در خودروهای خودران ما هستند. آنها بسیار پیچیده هستند، آموزش آنها دشوار است، و در حالی که شما نیازی به مشخص کردن ویژگی های خاص ندارید (گربه دارای خز، دم، چهار پا و غیره است) باید به CNN میلیون ها نمونه از گربه ها را قبل از آن نشان دهید. می تواند موفق باشد. حجم زیاد داده های آموزشی یک مانع بزرگ است.
شبکه های عصبی مکرر (RNN):RNN ها در مرکز پردازش زبان طبیعی (NLP) و همچنین بازی و مشکلات منطقی مشابه قرار دارند. برخلاف CNN ها، اطلاعات را به عنوان یک سری زمانی پردازش می کنند که در آن هر قطعه داده بعدی به نحوی به قطعه قبلی متکی است. ممکن است واضح نباشد اما گفتار در این دسته قرار می گیرد زیرا کاراکتر بعدی یا کلمه بعدی به طور منطقی با شخصیت قبلی مرتبط است. RNN ها می توانند در سطح کاراکتر، کلمه یا حتی پاراگراف طولانی کار کنند که آنها را برای ارائه پاسخ طولانی مورد انتظار به سؤال خدمات مشتری شما عالی می کند. RNN ها هم درک سوال متن و هم فرمول بندی پاسخ های پیچیده از جمله ترجمه به زبان های خارجی را مدیریت می کنند. RNN ها همچنین مسئول برنده شدن رایانه ها در شطرنج و Go هستند.
شبکه های عصبی متخاصم مولد (GANN):CNN ها و RNN ها هر دو از مشکل یکسانی در مورد نیاز به مقادیر عظیم و سنگین داده برای آموزش رنج می برند، یا برای تشخیص آن علامت توقف (تصویر) یا یادگیری دستورالعمل های لازم برای پاسخ به سوال شما در مورد نحوه باز کردن آن حساب (سخنرانی و متن). GANN ها این نوید را دارند که می توانند به طور چشمگیری داده های آموزشی را کاهش دهند و همچنین دقت را به طور چشمگیری افزایش دهند. آنها این کار را با جنگیدن با یکدیگر انجام می دهند. به طور خلاصه، یک سی ان ان بر روی نقاشی های امپرسیونیستی واقعی فرانسوی آموزش دیده است تا قرار است نقاشی های واقعی را بشناسد. CNN متخاصم دیگر، به نام شبکه عصبی متخاصم مولد، وظیفه ایجاد نقاشی امپرسیونیستی جعلی را بر عهده دارد.
CNN ها وظیفه خود را در تشخیص تصویر با تبدیل مقادیر پیکسل به بردارهای عددی پیچیده انجام می دهند. اگر آنها را به عقب اجرا کنید، با بردارهای عددی تصادفی شروع کنید، آنها می توانند یک تصویر ایجاد کنند. در این سناریو، Generative NN که تقلبی ایجاد میکند، تصاویری را تولید میکند که سعی میکنند CNN را فریب دهند که تلاش میکند یاد بگیرد چگونه تقلبیها را تشخیص دهد. آنها با آن مبارزه می کنند تا زمانی که Generative (سازنده جعلی) تصاویری آنقدر خوب تولید کند که CNN نمی تواند آنها را از اصلی تشخیص دهد و دو شبکه متخاصم به تساوی کشیده می شوند. در همین حال، سیانان طراحیشده برای تشخیص نسخههای اصلی از تقلبیها، در تشخیص تقلبیها بدون نیاز غیرواقعی برای میلیونها استاد امپرسیونیست جعلی فرانسوی آموزش عالی دیده است. به طور خلاصه این یادگیری از محیط آنهاست.
ماشین های پرسش و پاسخ (QAMs):QAM نام نسبتاً ناخوشایندی است که ما برای افرادی مانند واتسون IBM می گذاریم. اینها مخازن دانش عظیمی هستند که آموزش دیده اند تا پیوندهای منحصر به فردی را در پایگاه دانش خود بیابند و پاسخ سوالات پیچیده ای را ارائه دهند که قبلاً ندیده اند. در جایی که جستجوی معمولی فهرستی از منابعی را که ممکن است پاسخ شما در آنجا پیدا شود، برمی گرداند، QAM ها باید بهترین پاسخ را ارائه دهند.
این ترکیبی از NLP و جستجوی پیچیده است که در آن QAM فرضیههای متعددی را در مورد معنای احتمالی سؤال ایجاد میکند و بهترین پاسخ را بر اساس الگوریتمهای شواهد وزنی برمیگرداند.
QAM ها برای بارگذاری توسط انسان ها به حجم زیادی از داده ها در مورد موضوع مورد مطالعه نیاز دارند و سپس انسان ها باید پایگاه دانش را آموزش داده و حفظ کنند. با این حال، پس از تاسیس نشان داده شده است که آنها در زمینه هایی مانند تشخیص سرطان (در ارتباط با CNN)، تشخیص پزشکی، کشف ترکیبات منحصر به فرد مواد و مواد شیمیایی، و حتی در آموزش نحوه برنامه ریزی به دانش آموز دبیرستانی متخصص هستند. به طور خلاصه، هر جا که دانش بسیار بزرگی وجود داشته باشد که نیاز به تفسیر متخصص دارد، یک QAM می تواند مغز یا حداقل حافظه تداعی کننده هوش مصنوعی ما باشد.
سیستم های یادگیری تقویتی (RLS)
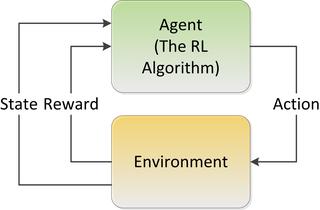
RLS روشی برای آموزش یک سیستم برای تشخیص بهترین نتیجه در پاسخ مستقیم به محیط است. در اینجا یک الگوریتم واحد وجود ندارد بلکه گروهی از برنامه های کاربردی سفارشی وجود دارد. RNN ها را می توان به عنوان یکی از انواع “عامل” در RLS استفاده کرد. RLS فناوری اصلی در خودروهای خودران و دستگاههای مشابه است که به رابط زبانی نیاز ندارند. اساساً این روشی است که به وسیله آن ماشینها میتوانند بهترین اقدام را تحت مجموعهای از شرایط خاص از آن یاد بگیرند و به خاطر بسپارند. هنگامی که ماشین خودران شما تصمیم می گیرد به جای عبور از چراغ زرد بایستد، از RLS برای ایجاد این رفتار آموخته شده استفاده می شود.
رباتیک
حوزه رباتیک برای هوش مصنوعی مهم است زیرا روش اولیه ای است که علم داده های هوش مصنوعی خود را در دنیای واقعی نشان می دهد. بیشتر رباتیک مهندسی ساده و بسیار پیچیده است. هوش مصنوعی پشت روباتیک در درجه اول یادگیری تقویتی است.
شبکه های عصبی اسپایکینگ (معروف به محاسبات نورومورفیک)
معمولاً گفته می شود که ما در نسل دوم هوش مصنوعی هستیم که عمدتاً بر اساس پیشرفت های سخت افزاری انجام شده است که به ما امکان می دهد از تغییراتی در الگوریتم هایی مانند شبکه های عصبی استفاده کنیم که به سادگی در گذشته امکان پذیر نبودند. اما همه اینها خیلی سریع در حال حرکت است و ما در آستانه انتقال به نسل سوم هوش مصنوعی هستیم.
نسل سوم مبتنی بر شبکههای عصبی Spiking است که محاسبات نورومورفیک نیز نامیده میشود، زیرا تلاش میکند تا نحوه عملکرد واقعی مغز را با دقت بیشتری تقلید کند. هسته اصلی این تغییر حول این واقعیت است که نورونهای مغز دائماً با یکدیگر ارتباط برقرار نمیکنند، بلکه به صورت موجهایی از سیگنالها ارتباط برقرار میکنند. چالش این است که بفهمیم چگونه یک پیام باید در این قطار از میخ های الکتریکی رمزگذاری شود.
این در اواسط مرحله تحقیق تا کنون است و من فقط از دو مورد که در کاربردهای تجاری استفاده شده است مطلع هستم. ممکن است تعداد بیشتری هنوز در حالت مخفی کاری وجود داشته باشد. سرمایه گذاری و قدرت مغز زیادی روی این توسعه سرازیر می شود. همچنین به نوع جدیدی از تراشه نیاز دارد که به معنای یک انقلاب سخت افزاری دیگر است.
هنگامی که آنها وارد می شوند، انتظار داریم موارد زیر باشد:
- آنها می توانند از یک منبع یاد بگیرند و آن را در منبع دیگر اعمال کنند. آنها می توانند در مورد محیط خود تعمیم دهند.
- آنها می توانند به خاطر بسپارند. کارهایی که پس از یادگیری می توانند به یاد بیاورند و روی داده های دیگر اعمال شوند.
- آنها بسیار کارآمدتر انرژی هستند که مسیری را برای کوچک سازی باز می کند.
- آنها بدون نظارت و با مثال ها یا مشاهدات بسیار کمی از محیط خود یاد می گیرند. این باعث می شود آنها به سرعت یادگیر شوند.
همگام با هوش مصنوعی
برای همگام شدن با هوش مصنوعی این فناوری ها و این دو روند را دنبال کنید.
- تجاری سازی هوش مصنوعی همانطور که در حال حاضر وجود دارد (نسل دوم) تقریباً برای همه چیز به همان سرعتی که بزرگان و همچنین میزبانی از استارت آپ ها می توانند انجام دهند، اعمال می شود. این احتمال وجود دارد که این امر به اندازه برقی شدن ایالات متحده در دهه 1920 فراگیر باشد.
- مراقب پیشرفتهای Spiking Neural Nets باشید تا این همه شگفتانگیزتر شود.
